
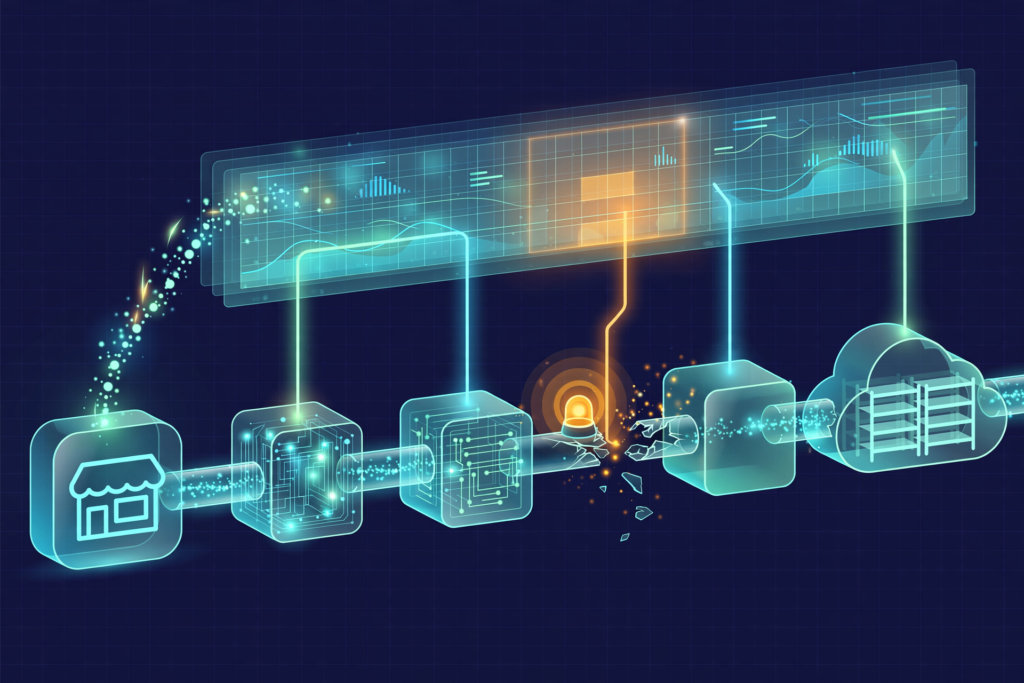
Le contexte : le pipeline e-commerce qui aurait pu coûter 40k€
La data observability pipeline ETL monitoring reste souvent un sujet abstrait. Chez nous, elle a un montant précis en face : 40k€. Voici le contexte réel, les tools, les seuils, et ce qu’on referait autrement.
Ce client est un marchand e-commerce européen de taille intermédiaire. Un catalogue de plusieurs milliers de références, un flux de commandes quotidien, des pics marqués pendant les soldes. Chez lui, le réassort se pilote depuis des tableaux de bord alimentés par la data. Sa stack existait avant notre arrivée et elle tenait la route : Fivetran pour l’ingestion, dbt pour la transformation, Snowflake pour le stockage. Un pipeline propre, un ETL lisible, sans sur-ingénierie.
Le problème n’était pas la stack, mais son silence. Quand Fivetran ingérait une table de travers, quand un modèle dbt produisait une colonne vide, quand le schéma bougeait côté source, personne ne le savait avant que le métier s’en aperçoive. Le monitoring restait vert, le pipeline aussi. La donnée, elle, était fausse. Une data observability sérieuse commence exactement là : au moment où le pipeline va bien mais où la donnée ne va pas.
Le scénario évité tient en 3 lignes. Une dérive silencieuse de schéma sur les données de stock. Une colonne renommée côté source, absorbée sans erreur par l’ingestion, qui continue de tourner au vert. Un inventaire désynchronisé pendant 48h si personne ne l’avait vue. Sur cette durée, le coût se calcule vite : ventes perdues sur des références fantômes, remboursements, commandes annulées. C’est le genre d’incident que le monitoring classique ne voit jamais, et que la data observability est faite pour attraper.
Ce que l’observabilité a préservé : 40k€ de chiffre d’affaires. Pas 40k€ de coût d’infrastructure, 40k€ de pertes réelles évitées pour le client. C’est ce chiffre, en langage business, qui a débloqué la décision en interne, pas nos tableaux de bord.
Pourquoi le monitoring classique ne suffit plus
Il faut distinguer 2 choses qu’on confond en permanence. Le monitoring répond à une question : est-ce que le pipeline tourne ? La data observability en pose une autre : est-ce que la donnée qui en sort est correcte ? Ce ne sont ni les mêmes metrics, ni les mêmes personnes réveillées à 3h du matin.
Le monitoring d’infrastructure surveille des ressources : CPU, RAM, uptime, espace disque, taux d’erreur. C’est utile, on le garde. Mais sur un data pipeline, ces signaux passent à côté de l’essentiel. Un job peut tourner en 4 minutes, consommer 2% de CPU et produire une table entièrement fausse. Le pipeline est vert, la donnée est cassée. C’est la panne silencieuse, et c’est le vrai danger d’une stack data sans observability.
Les 3 limites du monitoring seul :
- Il détecte ce qui casse franchement, pas ce qui dérive lentement.
- Il raisonne par composant, alors qu’un incident data traverse toute la chaîne : source, ingestion, transformation, consommation.
- Il ignore le métier. Une chute de volume de 20% sur les commandes n’a pas la même gravité qu’une variation identique sur des logs de navigation.
D’où les 5 piliers de l’observabilité data, quels que soient les tools utilisés. Ces 5 piliers, c’est le socle de toute data observability qui tient debout.
- Freshness : l’âge de la donnée. Quelle est la dernière ligne livrée, et quand ?
- Volume : le nombre de lignes livrées, comparé à son historique.
- Distribution : la forme des valeurs, avec le null rate, les min, les max et les valeurs hors intervalle attendu.
- Schema : les colonnes présentes, leur type, leur ordre.
- Lineage : le traçage amont et aval. Quelle table source a produit cette table cassée, et qui la consomme en downstream ?
Un insight qu’on a mis du temps à accepter : la propreté de la donnée est un problème de process, pas d’outil. Tu peux empiler 4 plateformes de data quality, si personne ne surveille les conventions de nommage et les changements de schéma côté source, le problème revient par la fenêtre. Une observability qui ne change pas les process ne sert à rien.
La reliability, dans tout ça, ne vient jamais d’un outil magique. Elle vient d’une combinaison : des metrics techniques, des metrics de data quality, des alerts actionnables, et quelqu’un qui sait quoi faire quand une alert sonne. En observability, c’est ce dernier point qui compte vraiment. Il faut monitorer la donnée autant que les serveurs.
La stack d’observabilité qu’on a déployée
On a construit cette stack de data observability par couches, avec une règle simple : chaque brique doit pouvoir être retirée sans casser les autres. Une observability mal branchée crée plus de bruit que de valeur, et nos pipelines data n’ont pas besoin de ça.
Couche 1 : ingestion, transformation, stockage (déjà en place)
- Fivetran pour l’ingestion. Connecteurs managés, reprise automatique, gestion des changements de schéma côté source. C’est lui qui absorbe le schema drift, exactement le piège dont on parle plus bas.
- dbt pour la transformation. Modèles SQL versionnés dans Git, dépendances déclarées, run results exploitables. Chaque exécution produit des métadonnées qu’on récupère pour le monitoring ETL.
- Snowflake pour le stockage. C’est aussi la source de vérité des tableaux de bord métier, et la table de facturation des credits consommés.
Couche 2 : collecte et stockage des metrics
- Telegraf comme agent de collecte. Il interroge les API de Fivetran, lit les run results de dbt, requête l’historique Snowflake, et pousse le tout dans un format de série temporelle unique.
- InfluxDB comme base temporelle (TSDB). C’est elle qui conserve l’historique des metrics et permet de calculer les moyennes glissantes nécessaires à l’anomaly detection.
- Grafana pour les dashboards et la visualisation : heatmap de fraîcheur, jauges de null rate, courbes de volumétrie et de coût par pipeline.
Couche 3 : alerting
- PagerDuty pour le routage et l’escalade. Grafana déclenche, PagerDuty décide qui est réveillé et quand on escalade.
Pourquoi ces tools plutôt qu’une plateforme tout-en-un :
- Open source : Telegraf, InfluxDB et Grafana. Le coût de mise en place se résume au coût d’infrastructure, quelques dizaines d’euros par mois sur une petite instance.
- Compatibilité : les 3 parlent le même dialecte de metrics. Ajouter une source coûte un connecteur, pas une migration.
- Contrôle : les seuils, les règles de calcul et l’historique restent chez nous. Aucun changement de tarif ne peut éteindre nos alerts.
Côté architecture, il faut visualiser 2 flux distincts. Le flux de données part de la boutique et de l’ERP, passe par Fivetran, traverse dbt, atterrit dans Snowflake et finit dans les tableaux de bord métier. Le flux de metrics est parallèle : chaque étape expose des métadonnées que Telegraf aspire en continu, stocke dans InfluxDB et affiche dans Grafana. Les 2 flux ne se croisent jamais, et c’est volontaire : si le flux de données casse, le flux de metrics continue de te dire où et pourquoi. Cette séparation, c’est 80% de la reliability d’une stack de data observability, et elle protège directement le business.
Les 5 métriques clés qu’on surveille en continu
Un dashboard de 40 panneaux ne sert à rien. En observability, moins de metrics bien choisies valent mieux qu’un mur de courbes. On distingue les metrics techniques (latence, durée d’exécution) des metrics décisionnelles, celles qui parlent au business (volumétrie, fraîcheur, data quality). Les premières servent la performance, les secondes protègent le chiffre d’affaires.
Le tableau ci-dessous résume les 5 metrics qu’on suit, leur seuil et l’action déclenchée. Les seuils sont ceux qu’on a paramétrés chez ce client, ils ne sont pas universels.
| Métrique | Question métier | Seuil d’alerte | Action |
|---|---|---|---|
| Volumétrie | A-t-on reçu toutes les commandes ? | Chute de plus de 20% vs moyenne glissante sur 7 jours | Alert P2, vérification du connecteur source |
| Fraîcheur | Les données sont-elles à jour ? | Dernière livraison de la table commandes à plus de 15 minutes en heures ouvrées | Alert P1, page d’astreinte |
| Null rate | Les champs critiques sont-ils fiables ? | Plus de 5% de NULL sur les colonnes prix ou stock | Alert P2, blocage du rafraîchissement |
| Schema drift | Le schéma a-t-il bougé sans prévenir ? | Colonne disparue ou changement de type sur une source | Alert P1, gel des transformations |
| Coût | Le pipeline coûte-t-il ce qu’il devrait ? | Budget journalier de credits dépassé de 50% | Alert P3, ticket pour le lendemain |
Volume et fraîcheur des données
Ce sont les 2 signaux les plus rentables, et les plus simples à mettre en place. Le premier : si la volumétrie de lignes ingérées chute de plus de 20% par rapport à la moyenne glissante des 7 derniers jours, on alerte. Une chute brutale veut presque toujours dire la même chose : un connecteur s’est arrêté, une API a renvoyé une page vide, un filtre a été cassé en amont. En observability, les checks de volumétrie sont le premier réflexe à installer sur tes pipelines.
Le second : la freshness. On monitore l’âge de la donnée sur les tables critiques, avec un SLA explicite. Sur la table commandes, il est de 15 minutes pendant les heures ouvrées. Si la dernière livraison dépasse ce délai, des alerts partent automatiquement. En observability, le tracking de freshness sur un data pipeline critique est la métrique qui coûte le moins cher et qui rapporte le plus.
Cas concret : un matin, une alert P1 tombe à 9h12. Freshness de la table commandes à 47 minutes. Les tableaux de bord métier affichaient encore les chiffres de la veille, et l’équipe achats allait lancer sa journée de réassort sur des données périmées. Diagnostic en 6 minutes : Fivetran n’avait pas ingéré les commandes de la nuit, un token expiré côté boutique bloquait la synchronisation. Refresh du token, resync, inventaire à jour avant 10h. Sans ce monitoring continu, on découvrait le problème en fin de matinée, après 2 réunions de réassort faussées.
Null rate et qualité des champs
La data quality se mesure champ par champ. Sur chaque colonne critique, on calcule le ratio de valeurs NULL, et on alerte si le null rate dépasse un seuil. Chez ce client : plus de 5% de NULL sur les colonnes prix ou stock déclenche une alert P2. Un prix NULL sur 6% des lignes, c’est un moteur de recommandation faussé, un réassort aveugle et des commandes vendues à un prix incohérent. C’est le genre de quality que seule une observability fine détecte.
Ces checks attrapent surtout les régressions silencieuses des transformations dbt. Un JOIN qui retourne moins de lignes qu’avant, une condition qui élimine une partie du catalogue, une macro modifiée par erreur : rien de tout ça ne casse techniquement. Tout est vert côté exécution, mais la table de sortie est partiellement vide. Une analysis de null rate par colonne révèle le problème en quelques secondes, là où un oeil humain mettrait des jours. Cette analysis automatique fait gagner des heures sur chaque incident.
Le calcul est simple : on interroge à intervalle régulier les tables Snowflake de sortie, on compare le null rate à la valeur de référence de la semaine précédente, et on alerte sur écart significatif. Cette approche de quality ne demande pas d’outil exotique, une requête planifiée par Telegraf suffit pour monitorer tes pipelines critiques.
Schema drift : l’ennemi silencieux
Voilà la métrique qui aurait pu coûter ces 40k€. Le schema drift, c’est le changement de structure d’une source upstream : une colonne renommée, une colonne supprimée, un type qui passe de texte à nombre. Ces changements sont souvent mineurs côté source, et dévastateurs en aval. En observability, c’est le type de dérive qu’aucun monitoring classique ne signale.
Deux niveaux de detection :
- Sur les sources : on compare le schéma observé à un schéma de référence, snapshoté. Toute colonne disparue ou tout changement de type déclenche une alert immédiate, avant même la première transformation.
- Sur les tables de sortie : on vérifie que les colonnes attendues existent et que les transformations dépendantes tournent toujours sur le même volume.
C’est là que le lineage devient indispensable. Quand une colonne disparaît, il ne suffit pas de le savoir : il faut identifier en quelques minutes quels modèles downstream sont touchés et quelle est la root cause. Si tu ne sais pas que la table stock alimente 4 tableaux de bord métier, tu vas éteindre l’alert sans mesurer l’impact réel sur le business.
Et c’est exactement le scénario évité chez ce client. Une colonne de disponibilité renommée côté source, absorbée sans erreur par l’ingestion. Le pipeline n’a rien signalé, parce qu’il n’y avait rien à signaler techniquement. Ce qui a parlé, c’est la combinaison d’une anomaly detection sur la volumétrie de la table stock et d’une alert de null rate. Sans ces 2 signaux croisés, l’inventaire restait faux 48h. C’est précisément ce silence que la data observability doit briser, et c’est là que les pipelines et leur lineage deviennent stratégiques.
Coût d’exécution des pipelines
L’observabilité ne sert pas qu’à éviter les pertes. Elle évite aussi les factures surprises. On track les Snowflake credits consommés par pipeline, ventilés par entrepôt et par modèle dbt. Un pipeline qui triple sa consommation en 1 semaine est un signal, même s’il tourne parfaitement. En observability, le cost est une métrique comme une autre.
Deux cas typiques de requêtes runaway : un modèle qui scanne une table entière au lieu d’une partition, et une jointure qui explose en produit cartésien parce qu’une clé est devenue non unique. Dans les 2 cas, le pipeline est vert, la performance s’écroule et le cost cloud grimpe. Ce sont les optimisations les plus rentables à lancer sur des pipelines e-commerce.
On a donc mis en place un budget alerting : alerte si le coût journalier d’un pipeline dépasse de 50% sa moyenne des 14 derniers jours. Ces alerts de cost ne réveillent personne la nuit, mais elles évitent les dérives qui finissent par justifier, à tort, qu’on coupe l’observability elle-même sur des pipelines pourtant sains.
Alertes automatisées avec PagerDuty
Une métrique qui alerte mal est pire qu’une métrique absente. En observability, le routage compte autant que la detection. On a donc classé nos alerts par sévérité, de P1 à P5 :
- P1 : impact business immédiat (fraîcheur cassée sur les commandes, schema drift sur une table critique). Page téléphonique, escalade au bout de 15 minutes.
- P2 : qualité dégradée sans impact immédiat (null rate hors seuil, chute de volumétrie). Notification, escalade en heures ouvrées.
- P3 : dérive de cost ou de performance. Ticket automatique, aucune interruption.
- P4 et P5 : signaux faibles et tendances. Ils alimentent la revue hebdomadaire, jamais la nuit.
La règle d’escalade qui a changé notre quotidien : aucune alert P1 ne part si elle n’est pas corrélée à une anomalie réelle sur au moins 2 metrics. Un faux positif coûte cher en trust, et une équipe qui ne croit plus à ses alerts finit par les couper.
Le payload que PagerDuty reçoit n’est jamais un simple pipeline en échec. Il contient le contexte métier : nom de la table concernée, seuil dépassé, valeur observée et valeur attendue, liste des tableaux de bord downstream et référence du dashboard Grafana associé. L’astreinte ouvre l’alert et sait en 30 secondes si elle doit intervenir. Cette pratique d’alerting contextuel, entièrement automated, a fait plus pour notre reliability que n’importe quel outil ajouté ensuite.
Récit de l’incident : comment on a détecté et évité la perte de 40k€
La timeline, en clair.
- Détection : une anomalie de volumétrie sur la table stock, croisée à une remontée de null rate sur la colonne de disponibilité. 2 metrics, une seule alert.
- Diagnostic : le lineage remonte de la table de sortie vers la source. La colonne d’origine a été renommée dans l’ERP, l’ingestion a continué sur l’ancien nom et produit une colonne vide.
- Résolution : correction du mapping côté transformation, resync de la table stock, rechargement complet de l’inventaire.
- Vérification : null rate redescendu sous 1%, volumétrie revenue dans l’intervalle attendu, tableaux de bord métier à jour.
Le point important, c’est le schema drift qui a failli passer inaperçu. Aucun test technique n’aurait échoué. Aucune alert d’infrastructure n’aurait sonné. Le pipeline aurait continué de tourner, proprement, pendant 48h, en alimentant un inventaire faux. C’est le scénario type de l’incident data invisible, celui qu’aucun monitoring d’infrastructure ne voit.
Ce qui a déclenché l’intervention, c’est la combinaison d’une anomalie de volumétrie détectée automatiquement et d’un null rate anormal. L’alert est partie dans PagerDuty, l’astreinte a ouvert le dashboard Grafana associé, et a vu en 1 coup d’oeil la colonne de disponibilité passer de moins de 1% de NULL à plus de 80%. Identifier la root cause a pris quelques minutes grâce au lineage. C’est là que l’observability gagne sa place dans un budget.
L’impact business se chiffre ainsi : 48h d’inventaire faux, sur un catalogue de plusieurs milliers de références et un flux de commandes quotidien. Ventes perdues sur des références marquées disponibles alors qu’elles ne l’étaient pas, remboursements et gestes commerciaux sur les commandes annulées, et un coût moins visible mais bien réel : la trust des équipes dans leurs propres chiffres. Le total préservé sur cet incident : 40k€ de chiffre d’affaires. Là, l’analyse financière parle plus fort que n’importe quel argument sur la reliability.
Ce que je ferais différemment aujourd’hui : détecter les schema changes plus tôt, au niveau de la source, avant même l’ingestion. On a gagné 6 heures sur cet incident, on aurait pu en gagner 12 avec une surveillance directe du schéma de l’ERP. Notre observability est bonne sur l’aval, elle reste trop tardive sur l’amont de nos pipelines.
Structure de dashboard Grafana
Pour plus de visibilité, voici la structure du dashboard qu’on déploie. C’est l’interface visible de toute l’observability décrite plus haut.
Les 4 rangées de panneaux :
- Trends de volumétrie : courbe du nombre de lignes par pipeline, superposée à la moyenne glissante sur 7 jours, avec bande de tolérance de plus ou moins 20%.
- Heatmap de fraîcheur : une heatmap par table critique. Chaque case représente l’âge de la donnée, le rouge signale un dépassement de SLA d’un seul regard.
- Null rate gauges : une jauge par colonne critique (prix, stock, référence produit), avec seuil visuel à 5%.
- Cost per pipeline : barres empilées des credits Snowflake par pipeline, avec la ligne de budget journalier en repère.
Si tu n’as pas Grafana ? Les alternatives existent. Datadog couvre l’infrastructure et l’observabilité applicative dans un seul tools, avec un coût par hôte qui monte vite dès que tu multiplies les metrics custom. Monte Carlo ou Soda, côté data quality, apportent plus de detection prête à l’emploi mais restent des plateformes payantes. Une observability managée a un prix, et ce prix se justifie surtout quand tu n’as personne pour maintenir la plateforme. Notre choix de l’open source vient d’une contrainte simple : chez un e-commerce de cette taille, les insights doivent rester accessibles sans négocier un budget de plateforme chaque trimestre.
Les résultats concrets pour le client
Après 6 mois de recul, 4 résultats mesurables.
- Temps de détection : passé de plusieurs heures à quelques minutes. Sur ce type d’incident, chaque heure gagnée se traduit directement en commandes sauvées.
- Zéro incident data non détecté depuis la mise en place. Les incidents arrivent encore, forcément, mais ils sont vus avant que le métier ne les subisse.
- Confiance restaurée : les équipes achats et finance vérifient moins, décident plus. Le trust dans les données n’est pas un sujet de communication, c’est un gain quotidien.
- ROI : la mise en place nous a pris quelques semaines, pour un coût d’infrastructure de quelques dizaines d’euros par mois. Face aux 40k€ de pertes évitées sur un seul incident, le calcul ne se discute pas longtemps en comité de direction.
Le vrai apport, au-delà des chiffres, c’est le changement de posture. On est passé d’une équipe qui subit ses incidents à une équipe qui les anticipe. Investir en data observability, ce n’est pas acheter un outil de plus, c’est changer la façon dont l’équipe regarde sa donnée. La valeur ne vient plus seulement de l’exécution des transformations, elle vient de la donnée elle-même, de sa supervision et de son intégration continue dans les process métier. C’est exactement le mouvement que décrit notre veille : l’IA absorbe la complexité opérationnelle, l’humain garde la stratégie, et la valeur bascule de l’exécution vers la donnée et sa supervision.
Passe à l’action : mets en place l’observabilité sur ton pipeline
Tu n’as pas besoin de tout déployer d’un coup. Voici les 5 premières étapes, celles qui rapportent le plus vite. En observability, mieux vaut 3 métriques qui alertent juste que 30 qui dorment, et ces principes valent pour tous tes pipelines data.
- Choisis 3 tables critiques et branche la fraîcheur dessus. C’est le signal le plus rentable et le plus simple à mettre en place.
- Ajoute le suivi de volumétrie avec une moyenne glissante sur 7 jours et une tolérance de 20%.
- Monitore le null rate sur 2 ou 3 colonnes métier sensibles (prix, stock, identifiant client).
- Snapshot le schéma de tes sources et compare-le chaque jour pour détecter le schema drift avant qu’il ne touche l’aval.
- Route tes alerts par sévérité dès le départ, sinon tu satures ton astreinte en 2 semaines et tu perds tout le bénéfice.
Si tu veux aller plus vite, on t’accompagne pour auditer et mettre en place l’observabilité de ta stack data : cartographie des pipelines, choix des métriques, construction des tableaux de bord et des règles d’alerting.
Un dernier chiffre pour convaincre ta direction, en langage business. Selon McKinsey, les organisations data-driven ont 23x plus de chances d’acquérir des clients et 6x plus de chances de les retenir. L’observability n’est pas un coût d’infrastructure, c’est la condition pour que cette donnée soit digne de trust. Et l’IA absorbe de plus en plus la complexité opérationnelle : la valeur se déplace vers la donnée, sa supervision et son intégration par flux. Autant la rendre fiable maintenant, avec des pipelines que tu peux enfin monitorer sereinement.
Tu veux la même chose sur ton pipeline ? On t’accompagne pour auditer et mettre en place l’observabilité de ta stack data. Si tu veux suivre l’aventure, abonne-toi !
