Veille concurrentielle en e-commerce : ce qu’on automatise vraiment
La veille concurrentielle n’est pas un rapport annuel de 40 pages qu’on relit une fois. C’est un processus : on collecte des informations, on les analyse, puis on les diffuse à ceux qui décident. Quand ce processus tourne à la main, il consomme du temps et il arrive toujours après la bataille.
Il faut aussi distinguer les types de veille. La veille concurrentielle surveille les concurrents, la veille commerciale regarde les offres et les pratiques de vente, la veille stratégique lit les signaux de fond qui transforment un secteur entier. En pratique, la frontière est poreuse, j’y reviens juste après.
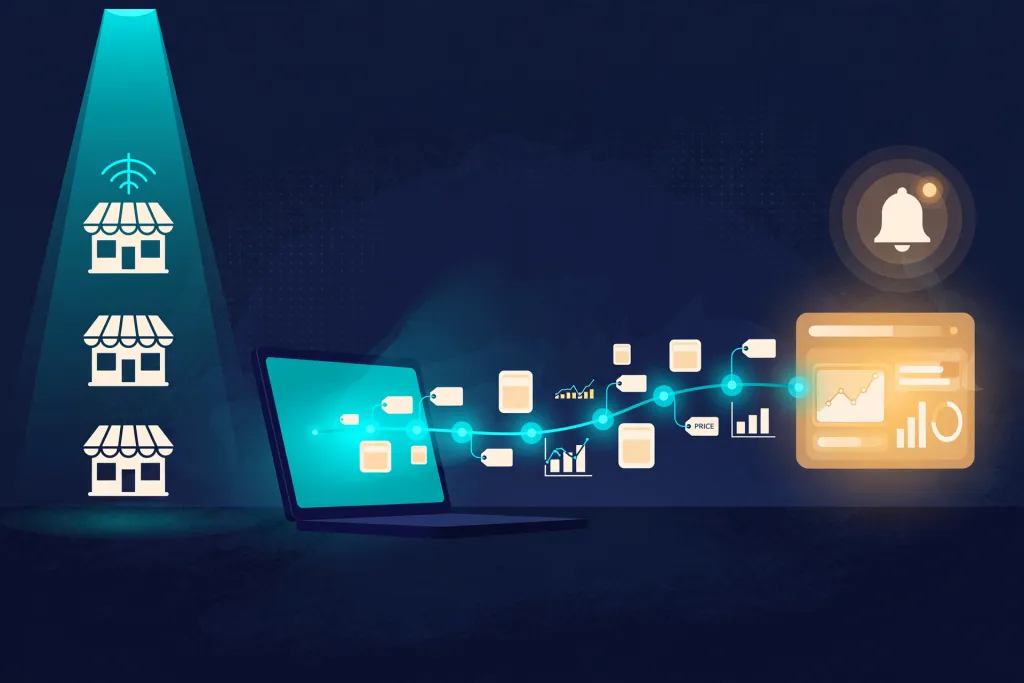
Cet article porte sur un cas précis : la veille prix et stock en e-commerce, automatisée de bout en bout. 5 concurrents directs relevés chaque nuit, un tableau de bord, une alerte Slack en cas d’écart, le tout dans un script Python orchestré par n8n. Le résultat mesuré sur le projet : 3h de veille manuelle par semaine ramenées à 15 minutes.
Définition : veille concurrentielle, stratégique et commerciale
Voici la définition opérationnelle que j’utilise quand je conçois une veille concurrentielle pour une entreprise e-commerce.
- Veille concurrentielle : suivre les prix, le stock, les nouveautés et les argumentaires des concurrents identifiés, pour adapter son propre positionnement.
- Veille commerciale : suivre les offres, les promotions, les canaux et les conditions de vente, pour ajuster ses opérations.
- Veille stratégique : suivre les tendances de marché, les évolutions technologiques et les menaces de moyen terme, pour construire une stratégie.
Ces trois types de veille se mélangent en permanence. Un changement de tarif chez un concurrent relève du concurrentiel, mais il annonce parfois une nouvelle offre, donc du commercial, qui traduit une stratégie marketing plus large, donc du stratégique. Ici, j’automatise le socle factuel : la veille concurrentielle des prix et des stocks. C’est la brique la plus vérifiable, et celle qui nourrit les deux autres.
Pourquoi la veille prix est le cas d’usage le plus rentable à automatiser
Relever des prix et des stocks coche toutes les cases d’une tâche automatisable : c’est répétitif, cadencé chaque jour, et basé sur des données structurées. Un script fait ce travail mieux qu’un humain, sans oubli et sans fatigue. Je n’ai jamais rencontré quelqu’un qui prenait du plaisir à recopier 300 tarifs dans un tableur un lundi matin.
La donnée qui bouge vite perd sa valeur vite. Un tarif relevé à la main une fois par mois n’a plus d’utilité décisionnelle. Une variation détectée le matin, après une promo lancée la veille au soir par un concurrent, vaut beaucoup plus cher pour ton entreprise.
Il y a un second argument, plus structurel. Le critère de sélection en e-commerce bascule : la mise en scène qui convainquait un acheteur humain pèse moins qu’une donnée vérifiable. Disponibilité réelle, tarif final frais inclus, délai de livraison, politique de retour : c’est ce qu’un agent d’achat compare. Des données produit incomplètes ou périmées suffisent à écarter un marchand des recommandations, sans que le client ait la moindre chance de découvrir son offre, comme le rappelle François-Xavier Thiébaud, chez Idealo France.
Le contexte donne l’échelle : environ 200 Md€ dépensés en ligne en France en 2025, mais un panier moyen en baisse. 78% des Français utilisent des assistants au quotidien et 39% s’en sont déjà servis pour un achat en ligne (Kantar, juin 2026). Checkout.com (août 2026) mesure que les agents d’achat ne jouent un rôle significatif que dans 3% des transactions en ligne aux États-Unis et au Royaume-Uni, avec un fossé générationnel net : 71% des 18-24 ans connaissent les agents d’achat contre 19% des 55 ans et plus. Adobe observe de son côté +693,4% de trafic des assistants génératifs vers les sites retail à la saison des fêtes 2025, en précisant que la base reste modeste. Autrement dit : le marché français n’a pas encore basculé, et c’est exactement ce qui rend la fenêtre intéressante pour rester compétitif.
Le pipeline de veille prix en un coup d’œil
Une veille concurrentielle automatisée, c’est 5 étapes qui s’enchaînent sans toi : collecte, normalisation, stockage, analyse, diffusion. Chaque étape a une fonction précise et un mode d’échec identifié. La bonne nouvelle : tu peux les construire une par une, sans tout casser à chaque ajout.
Le périmètre de référence du projet : 5 concurrents directs relevés chaque nuit, un tableau de bord unique, une alerte Slack dès qu’un écart dépasse le seuil défini. Avant automatisation, cette veille concurrentielle occupait 3h par semaine. Après, 15 minutes de lecture et d’arbitrage.
- Collecte : un scraper Python lit les fiches produit des concurrents directs.
- Normalisation : formats, devises et libellés alignés.
- Stockage : une ligne par produit et par date, pour historiser.
- Analyse : calcul des écarts et du positionnement relatif.
- Diffusion : tableau de bord lisible et alertes utiles.
L’architecture : 5 concurrents scrapés chaque nuit
Le schéma de cette veille concurrentielle est volontairement simple : une liste d’URLs produit en entrée, un scraper Python qui récupère les données, une sortie JSON normalisée, un stockage, un tableau récapitulatif, puis une notification Slack. Chaque brique peut être remplacée sans casser le reste, ce qui compte pour une entreprise qui veut itérer sans tout reconstruire.
- Liste d’URLs produit par concurrent, tenue à jour dans un fichier ou une feuille.
- Scraper Python lancé la nuit, qui extrait tarif, stock, délai, note et nombre d’avis.
- Sortie normalisée en JSON ou CSV, un enregistrement par produit.
- Écriture dans Google Sheets au démarrage, dans une base SQL quand le volume grandit.
- Lecture du tableau de bord et déclenchement des alertes en cas d’écart.
Pourquoi la nuit ? Parce que les sites concurrents sont moins sollicités, que le run ne gêne personne, et que les données sont prêtes au réveil. Côté volume, je suis restée sur un périmètre serré : 5 concurrents et une sélection de produits comparables, plutôt qu’un catalogue entier. Je préfère une collecte modérée mais régulière à un crawl massif qui finit bloqué.
Python pour scraper, n8n pour orchestrer
La répartition des rôles est nette. Python gère l’extraction et la logique de parsing : c’est là que le code reste le plus confortable pour lire un DOM capricieux. n8n gère le déclenchement, le passage de données, le stockage et les notifications : c’est là que l’orchestration visuelle fait gagner des heures.
Faire tout en Python pur se paie : il faut écrire son scheduler, gérer les reprises, coder chaque appel d’API et maintenir l’ensemble seul. Faire tout en n8n se paie aussi : parser du HTML complexe avec des nodes reste pénible, et la moindre variation de balise devient un casse-tête. La combinaison de ces deux outils donne le meilleur rapport entre puissance et maintenabilité d’une veille concurrentielle.
Le point de jonction est trivial : un node n8n de type Execute Command qui lance le script Python, ou un webhook qui appelle un petit service. Le script renvoie une sortie propre, n8n s’occupe du reste.
Le coût réel du dispositif
Il faut décomposer : hébergement du scraper, abonnement n8n si tu choisis la version cloud, proxies éventuels, stockage. Sur un périmètre raisonnable, l’ensemble tourne pour environ 15€/mois de hosting. Un petit serveur suffit, et les proxies ne deviennent nécessaires que si tu élargis beaucoup le nombre de sites visités.
Compare avec les outils spécialisés du marché : un abonnement de veille concurrentielle se compte souvent en centaines d’euros par mois, là où un crawl ponctuel avec Screaming Frog coûte environ 250€/an en version payante. Compare aussi avec le temps humain : 2h45 économisées chaque semaine, c’est le vrai gain pour ton entreprise.
Cela dit, le premier poste de coût n’est pas l’infrastructure. C’est la durée de construction initiale, quelques heures pour un périmètre serré, plus la maintenance quand un concurrent refait son site. Le moyen le plus simple de l’absorber : démarrer petit. Aucune entreprise e-commerce n’a besoin de couvrir tout son marché dès la première version.
Étape 1 : définir les informations à collecter
Commence par les objectifs, pas par le code. Quelles décisions cette veille concurrentielle doit-elle éclairer dans ton entreprise ? Un repositionnement tarifaire, la priorité donnée à un produit en rupture chez un concurrent, la préparation d’une offre. Si tu ne sais pas quoi faire des informations collectées, le pipeline produira un joli tableau que personne n’ouvrira.
Ensuite seulement, tu définis le périmètre : les concurrents directs réellement comparables et un échantillon de produits qui se recoupent. Suivre un concurrent qui ne vend pas les mêmes références ne sert à rien, sauf à collectionner des informations inutiles. Un échantillon de 20 produits bien choisis vaut mieux que 500 références au hasard, et il te permet de surveiller les vrais mouvements.
- Le prix affiché et le prix promotionnel.
- La disponibilité réelle, taille par taille quand le produit a des variantes.
- Le délai de livraison annoncé.
- La note moyenne et le nombre d’avis.
- La date du relevé, indispensable pour toute comparaison dans le temps.
Prix, stock, promotions : quelles données suivre en priorité
| Donnée | Fréquence de relevé | Usage décisionnel |
|---|---|---|
| Tarif final, frais de port inclus | Chaque nuit | Ajuster ton positionnement tarifaire |
| Tarif promo affiché | Chaque nuit | Anticiper une opération commerciale |
| Disponibilité réelle | Chaque nuit | Pousser un produit en rupture chez un concurrent |
| Délai de livraison annoncé | Chaque semaine | Comparer la promesse de service |
| Note et nombre d’avis | Chaque semaine | Suivre la fiabilité perçue du marchand |
| Stock par variante (taille, couleur) | Chaque nuit | Détecter les ruptures partielles |
Le tarif final, frais de port inclus, compte plus que le prix barré marketing. Un concurrent qui affiche -30% mais facture 6€ de livraison n’est pas moins cher, et ta veille concurrentielle se tromperait à te le faire croire. Même logique pour la disponibilité : ce qui compte, c’est le stock réel, pas la mention d’urgence. Sur les produits à variantes, suis le stock par taille ou par couleur : une rupture partielle est une opportunité, pas un détail.
Étape 2 : construire le scraper de prix en Python
Deux familles de bibliothèques couvrent 95% des cas rencontrés. requests et BeautifulSoup pour le HTML statique : simple, rapide, peu gourmand. Playwright quand le contenu est injecté en JavaScript. Le choix technologique se fait site par site, jamais une fois pour toutes, même au sein d’une même veille concurrentielle.
Structure le script autour d’un contrat clair : une liste d’URLs en entrée, un enregistrement normalisé en sortie. Peu importe le format, JSON ou CSV, tant que les champs sont toujours les mêmes. Un scraper qui renvoie des structures différentes selon les pages est inexploitable en aval, et ta veille concurrentielle devient un exercice de nettoyage manuel.
Gère les erreurs au lieu de laisser le run planter. Un site qui répond en 503, une page supprimée, un sélecteur vide : ce sont des cas normaux, pas des exceptions rares. Le script doit continuer, noter l’échec et te le signaler, sans casser la collecte des 4 autres concurrents.
Requests et BeautifulSoup ou Playwright : comment trancher
Le test le plus simple : désactive JavaScript dans ton navigateur et recharge la fiche produit. Si le tarif apparaît, requests suffit, et tu économises beaucoup de ressources. S’il n’apparaît pas, c’est qu’il est chargé après coup.
- Le tarif arrive par un appel API interne à la page.
- Le bloc de prix est en lazy loading et n’existe qu’après un scroll.
- Le site applique une protection anti-bot légère qui exige un vrai navigateur.
L’impact est direct sur ton coût d’hébergement et ta durée d’exécution. Un navigateur headless consomme beaucoup plus de mémoire que 3 requêtes HTTP. Garde Playwright pour les sites qui l’exigent, pas par confort.
Extraire un prix avec CSS Selector, XPath ou regex
Sur une même fiche produit, les trois méthodes fonctionnent. Voici comment je tranche, dans cet ordre.
- CSS Selector : le plus lisible. Je vise un attribut stable, du type data-price, itemprop= »price » ou la balise meta du tarif. C’est la méthode que je privilégie pour une veille concurrentielle durable.
- XPath : utile quand la position du bloc dans l’arbre compte plus que son nom, ou quand je dois remonter depuis un libellé.
- Regex : dernier recours, quand le DOM est instable. Je cible le bloc de tarif puis j’extrais le motif. Efficace, mais fragile : un changement de format et tout casse.
La règle : un sélecteur CSS stable bat toujours une classe générée du type css-8f3a2b. Si tu ne trouves que ça, cherche un attribut sémantique, une balise meta ou une donnée structurée dans la page. Ce sont ces points d’accroche qui survivent aux refontes, et donc à ta recherche d’informations fiables dans la durée.
Robustesse : rate limiting, retries et sélecteurs fragiles
La robustesse, c’est ce qui sépare un script qui marche un soir d’un pipeline qui tourne 12 mois. Elle se construit avec des garde-fous simples, pas avec de l’ingénierie lourde.
- Ralentis les requêtes et limite la concurrence : quelques requêtes par seconde suffisent pour surveiller des tarifs.
- Gère les timeouts et prévois un retry avec attente croissante sur les erreurs réseau.
- Détecte automatiquement un sélecteur qui ne renvoie plus rien : c’est le signal qu’une page a changé.
- Sauvegarde le HTML brut des échecs pour diagnostiquer sans relancer tout le processus de collecte.
Étape 3 : orchestrer le scraping avec n8n
Le workflow n8n fait 5 choses : déclencher, exécuter, transformer, stocker, notifier. Un node Schedule, un node qui lance le script Python, un node de transformation pour normaliser, un node d’écriture, un node Slack. Cet orchestrateur visuel garde le pipeline maintenable même quand tu n’es pas développeur : tu vois d’un coup d’œil où ça bloque, ce qui change tout dans une petite entreprise.
Pense l’observabilité dès le départ. Statut d’exécution visible, log en cas d’échec, possibilité de relancer un run à la main. Le jour où un concurrent change de site, tu veux le savoir en 30 secondes, pas au bout de 3 semaines sans données.
- Un statut de fin de run avec le nombre de produits relevés et le nombre d’échecs.
- Une notification d’erreur technique, distincte de l’alerte tarifaire.
- Une relance manuelle pour rattraper un run raté.
Déclencher le workflow chaque nuit
Un node Schedule suffit : une exécution quotidienne, à une heure creuse, avec le bon fuseau horaire. Vérifie ce détail, une alerte reçue à 3h du matin par erreur se remarque vite. En période de forte activité commerciale, avant des soldes par exemple, tu peux passer à 2 runs par jour sans changer d’architecture.
Attention aux exécutions concurrentes : si un run traîne, le suivant ne doit pas démarrer en parallèle. Un verrou simple, ou une surveillance de la durée d’exécution, évite deux écritures simultanées qui faussent l’historique et donc l’analyse.
Normaliser et stocker les données
La normalisation est l’étape la plus souvent négligée, et celle qui produit les erreurs les plus coûteuses. Uniformise le séparateur décimal, la devise, le libellé produit et l’identifiant du concurrent. Un 1 299,00 chez l’un et un 1299.0 chez l’autre, sans traitement, donnent une comparaison fausse et une décision erronée.
Écris une ligne par produit et par date : c’est ce qui permet d’historiser et de comparer dans le temps. Google Sheets suffit pour démarrer et reste lisible par une équipe non technique. Quand le volume grandit, passe à une base SQL : les requêtes d’écart et de tendance deviennent alors beaucoup plus simples à écrire.
Alerter Slack en cas d’écart
Définis un seuil, sinon l’alerte perd tout son sens. Notifier chaque variation de 1% noie l’information utile sous le bruit. Un seuil en pourcentage, plus un seuil en valeur absolue pour les produits chers, couvre la majorité des situations sans surcharger tes journées.
- Le produit concerné et le concurrent à l’origine du changement.
- L’ancien tarif, le nouveau, et l’écart en pourcentage.
- La date du relevé et le lien vers la fiche.
Autre garde-fou : regroupe les variations dans un digest quotidien plutôt que d’envoyer 14 messages. C’est la meilleure façon d’éviter la fatigue d’alerte, qui transforme un bon signal en bruit ignoré. Il faut aussi adapter le seuil selon les catégories : 5% sur un accessoire, ce n’est pas la même chose que 5% sur un produit à forte marge.
Étape 4 : construire le tableau de bord de veille prix
Structure le tableau de veille concurrentielle simplement : une ligne par produit, une colonne par concurrent, un historique de relevés. Tu obtiens une lecture immédiate du positionnement relatif, sans passer par 5 exports séparés.
- Le positionnement relatif de ton tarif face à chaque concurrent.
- La fréquence de changement par concurrent, révélatrice de leur rythme commercial.
- L’écart moyen sur ton échantillon de produits.
- Le nombre de ruptures repérées chez les concurrents.
Rends le tableau lisible pour une équipe non technique : des intitulés clairs, un code couleur sur les écarts, aucune colonne technique inutile. Un tableau que personne ne comprend ne sera pas utilisé, et ta veille concurrentielle restera un exercice solitaire sans effet sur les décisions marketing.
Alternative rapide : Screaming Frog Custom Extraction
Si tu veux tester l’idée avant d’écrire une ligne de code, la Custom Extraction de Screaming Frog extrait n’importe quelle donnée HTML via XPath, CSS Selector ou Regex. L’extraction des prix d’un e-commerce pour un monitoring concurrentiel est un cas d’usage documenté par l’outil. C’est l’alternative sans code la plus directe à un scraper maison.
Ses limites sont connues. La version gratuite plafonne à 500 URLs, et les images, le JS et le CSS comptent dans le quota. La version payante monte à 5 millions d’URLs pour environ 250€/an, et débloque le Database Mode, un stockage SQL local qui permet d’historiser les extractions et donc de comparer les tarifs dans le temps.
La règle de décision tient en une phrase : un crawl ponctuel pour comprendre un marché, un pipeline quotidien pour piloter des décisions. Si tu veux juste savoir où tu te situes ce mois-ci, cet outil suffit. Si tu veux une alerte dès qu’un concurrent baisse son tarif, ta veille concurrentielle a besoin du pipeline.
Le cadre légal et éthique du scraping de prix
Trois points de vigilance : les conditions d’utilisation du site, le fichier robots.txt, et la protection des données personnelles. Les tarifs affichés publiquement sont accessibles, mais l’accès automatisé reste encadré par les conditions du site, ce qui constitue la vraie limite juridique du dispositif. Et il est hors de question de collecter des données personnelles : tu n’en as pas besoin pour une veille prix, et elles n’ont rien à faire dans tes rapports.
Ce n’est pas de la veille juridique, et je ne suis pas juriste. Pour un usage industriel, fais valider l’encadrement juridique de ton dispositif par un professionnel du droit. Pour un usage raisonnable, une posture claire suffit à rester du bon côté.
- Respecte le robots.txt et les conditions d’utilisation.
- Identifie ton bot avec un User-Agent explicite.
- Limite ta cadence pour ne pas dégrader le service visité.
- Ne contourne aucune protection technique.
- Ne collecte que les informations produit nécessaires.
Les erreurs qui tuent une veille automatisée
J’ai planté ce pipeline de veille concurrentielle plusieurs fois avant qu’il tienne. La page d’un concurrent est passée en JavaScript, un sélecteur a renvoyé du vide pendant 4 jours sans que je le voie, et mon premier tableau n’a été lu par personne. Les erreurs techniques se corrigent. Les erreurs de méthode coûtent bien plus cher à une entreprise.
- Collecter sans objectif décisionnel clair.
- Relever trop de produits et jamais assez régulièrement.
- Déclencher des alertes sur toutes les variations, donc des alertes ignorées.
- Choisir des sélecteurs ultra-spécifiques, morts à la première refonte.
- Ne prévoir aucune alerte quand un relevé échoue.
- Ne rien historiser, donc ne rien pouvoir comparer.
- Oublier le rituel de lecture : les données dorment et la veille concurrentielle ne sert à rien.
Garde cette liste sous les yeux avant de passer en production. Un dispositif efficace est un dispositif dont tu connais les points de fragilité avant qu’ils cassent.
Sélecteurs, normalisation, alerting : les trois points de rupture
Si tu ne dois retenir que 3 risques sur une veille concurrentielle automatisée, ce sont ceux-là.
- Le sélecteur trop spécifique : il suffit d’une refonte chez un seul concurrent pour que la collecte s’arrête sans bruit.
- La donnée non normalisée : les comparaisons deviennent fausses, et les décisions qui en découlent aussi.
- L’alerte sur tout : sans seuil, l’alerte est ignorée, et tu perds tout le bénéfice de l’automatisation.
Des données aux décisions : le rituel de 15 min par semaine
Un pipeline ne décide pas à ta place. Il libère du temps pour la seule partie qui compte : l’analyse. Consacre 15 minutes par semaine à lire les écarts, arbitrer et noter ce que tu décides. Ce rituel transforme des lignes de tableau en actions concrètes.
- Lire les écarts au-dessus du seuil et les ruptures repérées chez les concurrents.
- Arbitrer : ajuster un tarif, pousser un produit, préparer une offre.
- Noter la décision et sa date, pour mesurer l’effet plus tard.
- Repérer un mouvement de fond, répété chez plusieurs concurrents.
Dernier point : cherche les tendances, pas la variation du jour. Une baisse isolée ne dit rien. Trois baisses successives chez un même concurrent, sur une même famille de produits, racontent une stratégie. C’est là que la veille concurrentielle devient de l’anticipation, et qu’elle mérite sa place dans ta stratégie commerciale plutôt que dans un rapport oublié.
FAQ : veille concurrentielle automatisée
Trois questions qui reviennent le plus souvent, avec des réponses courtes.
Est-ce légal de scraper les prix de ses concurrents ?
Les tarifs affichés publiquement sont accessibles, et aucun texte ne t’interdit de les consulter. La limite se situe ailleurs : les conditions d’utilisation du site, le robots.txt, et l’absence de contournement de protection technique. Pour un usage industriel, fais valider ton dispositif, et relis la section sur le cadre légal plus haut. C’est la réponse honnête : le scraping de prix est un terrain praticable, pas un terrain neutre.
Combien coûte un pipeline de veille prix ?
Sur un périmètre serré, compte environ 15€/mois d’hébergement pour tes concurrents relevés chaque nuit. Le montant monte avec le nombre de pages suivies et l’usage de proxies. Mais le vrai poste de coût reste la durée de construction initiale, pas l’infrastructure, et cet investissement se compare aux abonnements d’outils spécialisés du marché.
Python ou n8n : que choisir ?
Les deux, chacun sur son terrain. Python quand le parsing HTML est complexe, n8n quand l’enjeu est l’orchestration, le stockage et les notifications. Un seul des deux outils suffit si ton besoin est simple : un crawl occasionnel en Python pur, ou un flux de données propre sans parsing délicat en n8n seul. Pour une veille concurrentielle quotidienne sur plusieurs sites, la combinaison reste le meilleur compromis.
Conclusion : ta veille concurrentielle tourne pendant que tu dors
Le dispositif tient en 5 étapes : un scraper Python qui collecte les informations de 5 concurrents chaque nuit, n8n qui orchestre et stocke, un tableau de bord qui rend les écarts lisibles, une alerte Slack qui ne parle que quand ça compte. 3h de veille concurrentielle par semaine ramenées à 15 minutes, pour environ 15€/mois de hosting et un résultat vérifiable dans tes décisions tarifaires.
Démarre petit : 2 concurrents et 20 produits suffisent pour valider la mécanique et repérer les pièges sur un périmètre maîtrisé. Élargis ensuite, une fois que le run nocturne est stable et que le rituel hebdomadaire est ancré dans ton entreprise. C’est le moyen le plus efficace de rester compétitif sans sacrifier tes lundis matin.
Et garde en tête l’essentiel : cet assemblage ne remplace pas ton analyse. Il te rend le temps de la faire, ce qui reste la seule façon d’anticiper vraiment les mouvements de ton marché, qu’ils viennent d’un concurrent ou d’un agent d’achat.
Si tu veux suivre l’aventure, abonne-toi !