Automatisation et RGPD : le sujet qu’on traite toujours trop tard
Un workflow qui crée un contact dans le CRM, un agent IA qui lit les e-mails entrants, un chatbot qui répond aux clients, une séquence de prospection qui enrichit des fiches : tous ces outils manipulent des données personnelles. Des noms, des adresses e-mail, des numéros de téléphone, parfois le contenu de conversations entières. Le RGPD s’applique donc à chacun d’eux, exactement comme à un fichier client.
Pourtant, la conformité arrive presque toujours en dernier, quand le workflow tourne déjà et que quelqu’un pose la question : « au fait, où vont ces données ? » À ce stade, il faut parfois tout reprendre. Bien pensée dès la conception, la conformité ne ralentit pas un projet d’automatisation : elle évite au contraire de devoir le refaire.
Dans cet article, je passe en revue les points RGPD à vérifier quand tu automatises avec n8n, Make, Zapier ou des agents IA, avec les réglages concrets qui font la différence et une checklist à la fin. Une précision avant de commencer : je suis consultante en automatisation et en data, pas juriste. Ce guide t’aide à poser les bonnes questions ; pour les cas délicats, implique ton DPO ou un avocat spécialisé.
Pourquoi un workflow est un traitement de données comme un autre
Pour le RGPD, un traitement est toute opération appliquée à des données personnelles : collecter, enregistrer, transférer, modifier, effacer. Un workflow automatisé fait souvent tout cela en quelques secondes, et à travers plusieurs outils. Il hérite donc de toutes les obligations du règlement.
Il ajoute même des risques spécifiques, que les traitements manuels n’ont pas :
- la multiplication des copies : chaque outil traversé garde une trace des données, souvent dans un historique d’exécution que personne ne regarde ;
- la multiplication des sous-traitants : un seul workflow peut faire intervenir une plateforme d’automatisation, un CRM, un outil d’e-mailing et un fournisseur d’IA, chacun avec ses propres conditions ;
- le volume et la vitesse : une erreur de configuration se répète sur des milliers d’enregistrements avant que quelqu’un s’en aperçoive ;
- l’opacité : sans documentation, personne ne sait plus quelles données circulent entre quels outils.
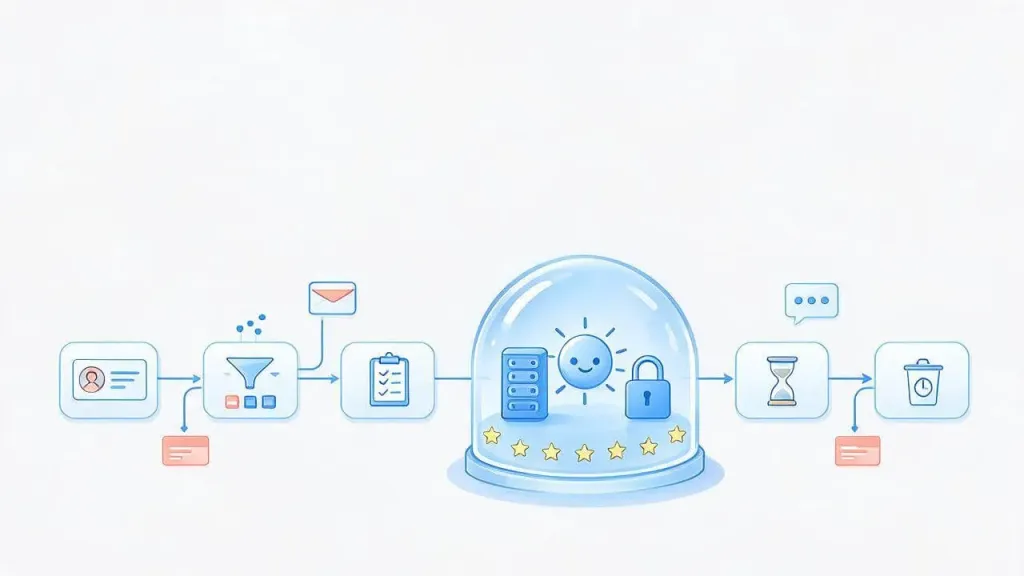
Les 6 questions à se poser avant de mettre un workflow en production
1. Quelle est la finalité, et sur quelle base légale ?
Chaque workflow doit servir un objectif précis : gérer une demande de devis, suivre un client, envoyer une newsletter, traiter une candidature. Cette finalité détermine la base légale : l’exécution d’un contrat pour le suivi d’une commande, l’intérêt légitime pour une prospection B2B encadrée, le consentement pour une newsletter grand public, une obligation légale pour la facturation. Un workflow qui réutilise des données pour un autre objectif que celui annoncé au départ pose problème, même s’il est techniquement très simple.
2. Quelles données sont vraiment nécessaires ?
C’est le principe de minimisation, et c’est là que l’automatisation pèche le plus souvent. Par facilité, on transmet la fiche complète d’un contact d’un outil à l’autre, alors que l’étape suivante n’a besoin que d’une adresse e-mail. Dans tes workflows, sélectionne explicitement les champs transmis à chaque étape, et surtout à chaque outil externe. C’est encore plus important quand une étape envoie du texte à un modèle d’IA, qui n’a presque jamais besoin du nom ou des coordonnées de la personne pour classer une demande.
3. Par quels outils passent les données, et où sont-ils hébergés ?
Dresse la liste de tous les services traversés par un workflow. Chacun d’eux est, en règle générale, un sous-traitant au sens du RGPD. Pour chacun, tu dois disposer d’un accord de traitement des données (le DPA, prévu par l’article 28) et connaître la localisation de l’hébergement. Si des données partent hors de l’Union européenne, il faut un cadre de transfert valable : une décision d’adéquation, comme le Data Privacy Framework pour les entreprises américaines qui y ont adhéré, ou à défaut des clauses contractuelles types.
4. Combien de temps les données sont-elles conservées, et où ?
On pense à la durée de conservation dans le CRM, beaucoup moins à celle des historiques d’exécution. Or n8n, Make et Zapier gardent par défaut une copie des données traitées à chaque passage, utile pour déboguer. Ces copies doivent avoir une durée de conservation définie, la plus courte possible compatible avec la maintenance.
5. Qui a accès aux workflows et aux identifiants ?
Une plateforme d’automatisation centralise des identifiants vers tous tes outils : CRM, messagerie, comptabilité, stockage de fichiers. Un accès non maîtrisé à cette plateforme ouvre donc la porte à tout le reste. Limite les comptes administrateurs, utilise des clés d’API aux droits minimaux et retire les accès dès qu’une personne quitte le projet.
6. Comment les droits des personnes sont-ils respectés ?
Quand une personne demande l’effacement de ses données ou s’oppose à la prospection, sa demande doit être appliquée dans tous les outils, pas seulement dans le CRM. C’est un cas où l’automatisation aide la conformité : un workflow dédié peut propager une désinscription ou une suppression à l’ensemble des outils, et garder une trace de la demande.
Les réglages concrets dans n8n, Make et Zapier
n8n : la maîtrise complète en auto-hébergement
Quand n8n est installé sur ton propre serveur, ou chez un hébergeur européen de ton choix, les données ne sortent pas de ton infrastructure, sauf vers les outils que tu appelles explicitement. C’est l’option la plus simple à justifier pour des données sensibles. Quelques réglages à connaître :
- Historique des exécutions : n8n permet de ne pas enregistrer les données des exécutions réussies, globalement ou workflow par workflow, et d’activer la purge automatique des exécutions au-delà d’une durée définie (variables
EXECUTIONS_DATA_SAVE_ON_SUCCESS,EXECUTIONS_DATA_PRUNEetEXECUTIONS_DATA_MAX_AGE). - Identifiants : ils sont chiffrés en base avec une clé de chiffrement propre à l’instance. Cette clé doit être définie explicitement, sauvegardée en lieu sûr et jamais versionnée avec le code.
- Webhooks : protège les points d’entrée publics par une authentification, et sers l’instance uniquement en HTTPS.
- Mises à jour : une instance auto-hébergée qui n’est plus mise à jour devient une faille. Prévois un rythme de mise à jour et une sauvegarde avant chacune.
C’est l’une des raisons pour lesquelles je travaille majoritairement avec n8n pour les clients qui manipulent des données sensibles.
Make : choisir sa zone et masquer les données
Make est un service en ligne qui permet de choisir une zone d’hébergement, notamment en Europe : c’est le premier réglage à vérifier au moment de créer l’organisation. Dans les paramètres d’un scénario, une option permet de marquer les données comme confidentielles, pour qu’elles ne soient pas conservées dans l’historique d’exécution. Active-la sur tous les scénarios qui traitent des données personnelles, en acceptant que le débogage soit un peu moins confortable.
Zapier : vérifier les transferts et nettoyer l’historique
Zapier est une entreprise américaine dont l’infrastructure est principalement aux États-Unis. Il faut donc vérifier le cadre de transfert prévu dans ses conditions et l’inscrire dans ton registre. L’historique des Zaps contient les données traitées : définis une politique de conservation et supprime les données dont tu n’as plus besoin. Pour les données les plus sensibles, pose-toi franchement la question de l’outil.
Automatisation, IA et RGPD : les points spécifiques
Les étapes d’IA ajoutent un sous-traitant de plus, le fournisseur du modèle, et une question nouvelle : que devient le texte envoyé ?
- Utilisation pour l’entraînement : les offres d’API professionnelles des principaux fournisseurs prévoient en général que les données envoyées ne servent pas à entraîner les modèles. Vérifie-le dans les conditions de l’offre que tu utilises réellement, et n’utilise jamais un compte grand public pour traiter des données de clients.
- Localisation : des modèles hébergés en Europe, ou un modèle open source installé sur ton infrastructure, évitent les transferts hors de l’Union.
- Pseudonymisation : avant d’envoyer un texte au modèle, remplace les noms, adresses et numéros par des marqueurs, puis réinsère-les dans la réponse si besoin. Une simple étape de code dans le workflow suffit souvent.
- Information des personnes : une personne qui échange avec un chatbot IA doit savoir qu’elle parle à une IA. C’est une bonne pratique, et une obligation de transparence prévue par le règlement européen sur l’IA.
Décisions automatisées : où placer l’humain
L’article 22 du RGPD encadre les décisions fondées exclusivement sur un traitement automatisé qui produisent des effets juridiques ou affectent la personne de manière significative. Un score qui trie des leads B2B pour prioriser les rappels n’entre généralement pas dans ce cadre. Un tri automatique de candidatures qui écarte des candidats sans intervention humaine, en revanche, demande une vigilance particulière. La règle pratique : dès qu’une décision automatisée pèse vraiment sur une personne, un humain doit pouvoir la revoir, et la personne doit pouvoir le demander. C’est aussi un principe que j’applique aux agents IA qui agissent dans des logiciels métier.
Le registre et l’analyse d’impact
Chaque workflow qui traite des données personnelles doit trouver sa place dans ton registre des traitements (article 30) : finalité, catégories de données et de personnes, destinataires, sous-traitants, transferts, durées de conservation, mesures de sécurité. Inutile de créer une ligne par workflow technique : un traitement métier, comme « gestion des demandes de devis », peut regrouper plusieurs workflows, à condition de lister les outils qu’ils utilisent.
Certains traitements demandent en plus une analyse d’impact (AIPD, article 35) : données sensibles à grande échelle, évaluation ou scoring systématique de personnes, surveillance, croisement de jeux de données. La CNIL publie la liste des traitements concernés. Si ton projet d’automatisation ou d’IA s’en approche, fais l’analyse avant la mise en production, pas après.
Les cas qui posent le plus souvent problème
- La prospection automatisée : enrichissement de contacts à partir de sources dont l’origine est floue, absence d’information des personnes, désinscription qui ne se propage pas à tous les outils. Ces points sont détaillés sur la page prospection automatisée.
- Les données qui dorment dans les historiques : des mois de données clients conservées dans l’historique d’une plateforme d’automatisation, sans que personne le sache.
- Les tableurs intermédiaires : un Google Sheet utilisé comme « tampon » entre deux outils, partagé largement et jamais purgé.
- Les comptes personnels : une automatisation créée sur le compte gratuit d’un salarié, qui part avec lui le jour où il quitte l’entreprise.
- Les e-mails analysés par l’IA : le contenu complet des messages envoyé à un modèle, alors qu’un extrait aurait suffi.
La checklist RGPD d’un workflow automatisé
| Point à vérifier | Question à se poser | Où agir |
|---|---|---|
| Finalité et base légale | Le workflow sert-il un objectif annoncé, avec une base légale identifiée ? | Registre des traitements, mentions d’information |
| Minimisation | Chaque étape reçoit-elle uniquement les champs dont elle a besoin ? | Configuration de chaque nœud ou module |
| Sous-traitants | Chaque outil traversé a-t-il un accord de traitement signé ? | Contrats, registre |
| Transferts hors UE | Les données quittent-elles l’Union, et avec quel cadre ? | Choix de l’outil, zone d’hébergement |
| Historiques d’exécution | Les copies de données ont-elles une durée de conservation courte ? | Paramètres de la plateforme d’automatisation |
| Accès et identifiants | Qui peut voir les workflows et les identifiants ? Les clés ont-elles des droits minimaux ? | Comptes, rôles, clés d’API |
| Droits des personnes | Une suppression ou une opposition se propage-t-elle à tous les outils ? | Workflow de propagation dédié |
| IA | Le texte envoyé au modèle est-il minimisé, pseudonymisé si besoin, et non réutilisé pour l’entraînement ? | Étape de préparation, choix du fournisseur |
| Documentation | Une personne de l’équipe peut-elle expliquer ce que fait le workflow et quelles données il traite ? | Fiche de documentation du workflow |
Conclusion : la conformité se construit dans le workflow, pas à côté
Le RGPD n’interdit pas d’automatiser, ni d’utiliser l’IA. Il demande de savoir quelles données circulent, pourquoi, par où et pour combien de temps. Ce sont exactement les questions qu’on devrait se poser de toute façon pour construire des workflows fiables et maintenables.
La méthode la plus efficace consiste à intégrer ces questions au cadrage de chaque automatisation : une ligne dans le registre, des champs sélectionnés à chaque étape, une durée de conservation des historiques, un accord de traitement par outil, une documentation à jour. Si tu veux faire le point sur tes automatisations existantes, un audit IA passe en revue tes workflows et leurs données en même temps que leurs gains.
Si tu veux suivre l’aventure, abonne-toi !